Beim Würfeln, bei Umfragen oder bei der Qualitätskontrolle entscheidet nicht alles der Zufall, aber vieles lässt sich auch nicht sicher vorhersagen. Die Stochastik liefert dafür ein mathematisches Werkzeug: Sie verbindet Wahrscheinlichkeitsrechnung mit Statistik und hilft, unsichere Situationen zu beschreiben, zu berechnen und sinnvoll zu beurteilen. Ich zeige die wichtigsten Begriffe, Formeln, Aufgabentypen und Denkfehler mit verständlichen Beispielen.
Zufall wird verständlich, wenn man ihn richtig modelliert
- Zwei Bereiche: Wahrscheinlichkeitsrechnung untersucht Zufall, Statistik wertet Daten aus.
- Grundidee: Ein Zufallsexperiment besitzt mögliche Ergebnisse und zugehörige Wahrscheinlichkeiten.
- Wichtige Werkzeuge: Baumdiagramm, Vierfeldertafel, Zufallsvariable und Binomialverteilung.
- Binomialmodell: Es passt nur, wenn es feste Versuchszahlen, zwei Ergebnisse und eine gleichbleibende Trefferwahrscheinlichkeit gibt.
- Gute Interpretation: Eine Wahrscheinlichkeit beschreibt ein Modell, aber keine sichere Vorhersage für den Einzelfall.
Was dieses Teilgebiet der Mathematik untersucht
Im Mittelpunkt stehen Situationen, deren Ergebnis vorher nicht eindeutig feststeht. Beim Münzwurf kennt man mögliche Ausgänge, aber nicht, ob beim nächsten Versuch Kopf oder Zahl erscheint. Mathematisch interessant wird das, weil sich solche Zufälle trotzdem mit Wahrscheinlichkeiten beschreiben lassen.
Das Fach hat zwei eng verbundene Seiten. Die Wahrscheinlichkeitsrechnung geht meist von einem Modell aus und fragt, welche Ergebnisse zu erwarten sind. Die Statistik startet mit beobachteten Daten und versucht, daraus Muster, Kennzahlen oder Aussagen über eine größere Gruppe abzuleiten.
| Bereich | Ausgangspunkt | Typische Frage |
|---|---|---|
| Wahrscheinlichkeitsrechnung | Modell und bekannte Wahrscheinlichkeiten | Wie wahrscheinlich sind genau drei Treffer? |
| Statistik | Beobachtete Daten | Was sagen 500 Befragte über eine größere Gruppe aus? |
Ich finde diese Trennung besonders hilfreich, weil viele Lernende beides vermischen. Ein Würfelmodell sagt voraus, was bei vielen Würfen ungefähr passieren sollte. Eine Tabelle mit den Ergebnissen tatsächlich durchgeführter Würfe beschreibt dagegen, was beobachtet wurde.
Von Zufallsexperimenten zur Wahrscheinlichkeit
Ein Zufallsexperiment ist ein Vorgang, dessen Ergebnis nicht sicher bekannt ist, obwohl die möglichen Ergebnisse feststehen. Beim Würfeln lautet die Ergebnismenge beispielsweise Ω = {1, 2, 3, 4, 5, 6}. Ein Ereignis ist eine Auswahl aus dieser Menge, etwa „eine gerade Zahl würfeln“.
Die Wahrscheinlichkeit eines Ereignisses A wird mit P(A) bezeichnet. Bei einem fairen Würfel gilt für das Ereignis „gerade Zahl“:
P(A) = 3 / 6 = 0,5 = 50 %
Diese einfache Rechnung funktioniert nach dem Laplace-Modell, wenn alle Ergebnisse gleich wahrscheinlich sind. Bei einem manipulierten Würfel oder beim Ziehen von Kugeln mit unterschiedlichen Gewichten reicht diese Regel nicht aus. Dann müssen die einzelnen Wahrscheinlichkeiten bekannt sein oder aus Daten geschätzt werden.
Baumdiagramme machen mehrere Schritte sichtbar
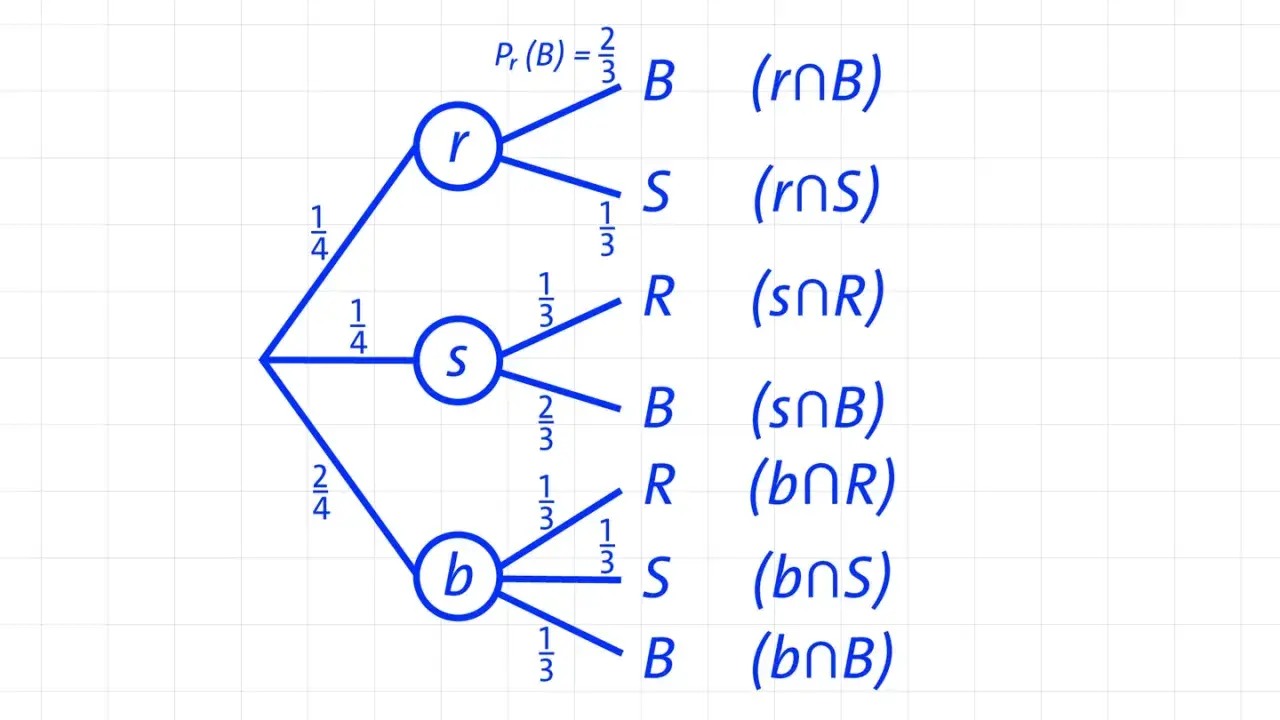
Bei mehrstufigen Experimenten nutze ich gern ein Baumdiagramm. Angenommen, in einem Beutel liegen 2 rote und 3 blaue Kugeln. Werden zwei Kugeln ohne Zurücklegen gezogen, verändert sich die Wahrscheinlichkeit nach dem ersten Zug.
- Rot, dann Rot: 2/5 · 1/4 = 1/10
- Rot, dann Blau: 2/5 · 3/4 = 3/10
- Blau, dann Rot: 3/5 · 2/4 = 3/10
- Blau, dann Blau: 3/5 · 2/4 = 3/10
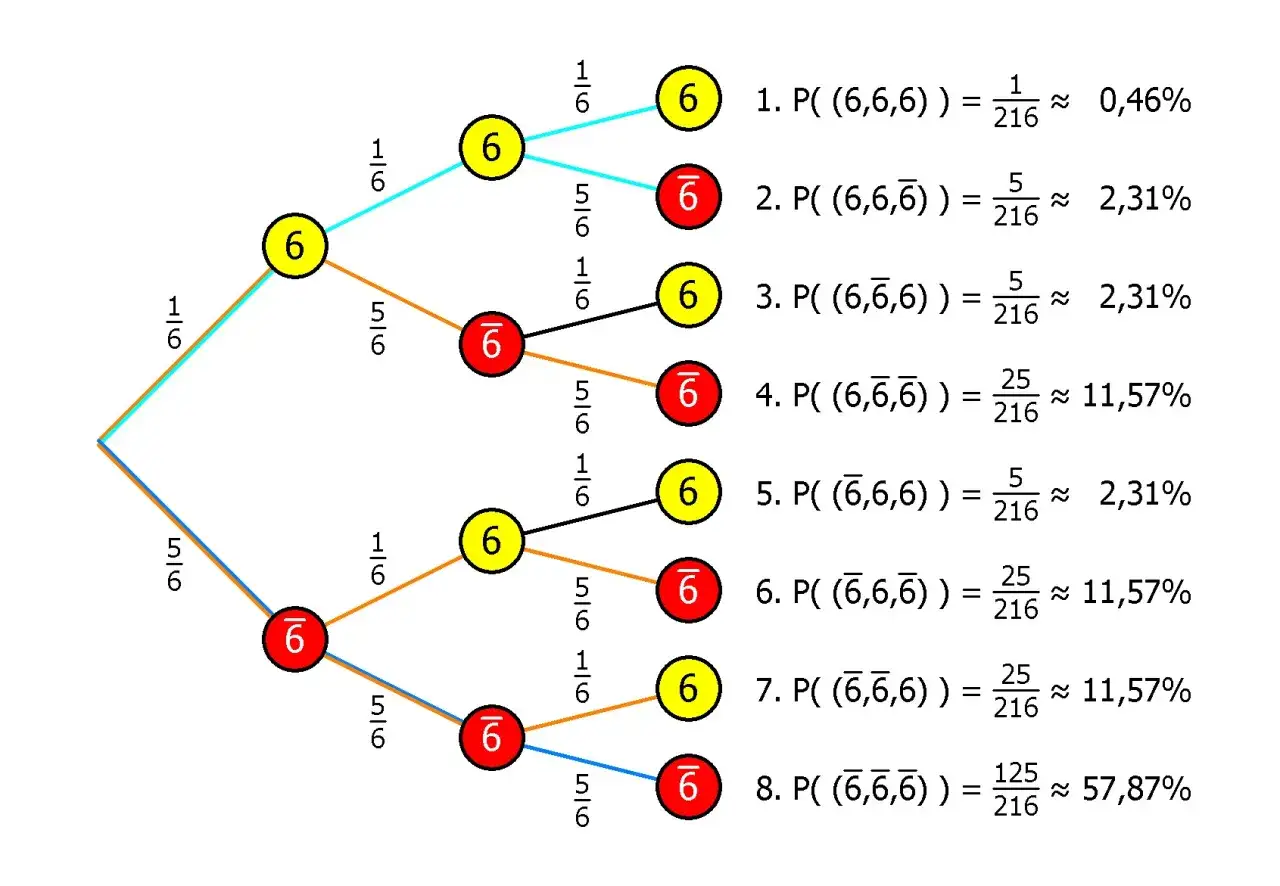
Entlang eines Pfades werden Wahrscheinlichkeiten multipliziert. Mehrere passende Pfade werden addiert. Genau hier passieren in Aufgaben die häufigsten Fehler: Lernende addieren entlang eines Pfades oder vergessen, dass sich die Wahrscheinlichkeiten ohne Zurücklegen ändern.
Welche Modelle und Kennzahlen besonders wichtig sind
Eine Zufallsvariable ordnet jedem möglichen Ergebnis eine Zahl zu. Bei zehn Würfen kann sie zum Beispiel zählen, wie oft Kopf erscheint. Dadurch wird aus einer Alltagssituation eine mathematische Größe, mit der sich Verteilungen und Kennzahlen berechnen lassen.
| Begriff | Bedeutung | Praktische Interpretation |
|---|---|---|
| Erwartungswert | Durchschnittlicher Wert bei sehr vielen Wiederholungen | Bei 100 Würfen mit Trefferchance 0,3 sind im Mittel 30 Treffer zu erwarten. |
| Varianz | Maß für die Streuung um den Erwartungswert | Sie zeigt, wie stark die möglichen Werte auseinanderliegen. |
| Standardabweichung | Quadratwurzel der Varianz | Sie gibt die Streuung in derselben Einheit wie die Zufallsvariable an. |
Die Binomialverteilung als Schulklassiker
Die Binomialverteilung beschreibt, wie oft ein bestimmtes Ereignis bei mehreren gleichartigen Versuchen eintritt. Sie ist nur dann passend, wenn die Versuchszahl n feststeht, jeder Versuch genau zwei relevante Ausgänge besitzt, die Trefferwahrscheinlichkeit p gleich bleibt und die Versuche unabhängig sind.
Für genau k Treffer lautet die Formel:
P(X = k) = n über k · pk · (1 - p)n-k
Der Erwartungswert einer binomialverteilten Zufallsgröße ist μ = n · p. Die Standardabweichung berechnet sich mit σ = √(n · p · (1 - p)). Die Formeln sind nützlich, aber erst die richtige Modellentscheidung macht das Ergebnis sinnvoll.
Eine Ziehung ohne Zurücklegen ist beispielsweise meist keine Binomialverteilung, weil sich die Trefferwahrscheinlichkeit verändert. Bei sehr großen Populationen kann eine Binomialverteilung manchmal als Näherung dienen, doch diese Vereinfachung sollte begründet werden.
So löse ich typische Aufgaben Schritt für Schritt
Bei Sachaufgaben hilft ein festes Vorgehen mehr als blindes Formeleinsetzen. Ich markiere zuerst, was gezählt wird, und prüfe danach, ob ein bestimmtes Ereignis, mindestens ein Treffer oder ein Intervall gesucht ist.
- Situation übersetzen: Was ist ein Treffer, wie viele Versuche gibt es und welche Wahrscheinlichkeit gehört dazu?
- Modell prüfen: Sind die Versuche unabhängig und bleibt p konstant?
- Gesuchtes Ereignis formulieren: Zum Beispiel X = 2, X ≥ 1 oder 3 ≤ X ≤ 6.
- Rechenweg wählen: Einzelwahrscheinlichkeit, Gegenereignis, kumulierte Wahrscheinlichkeit oder Baumdiagramm.
- Ergebnis deuten: Immer mit Einheit und Bezug zur Situation antworten.
Beispiel mit zehn Qualitätsprüfungen
Eine Maschine produziert mit einer Fehlerwahrscheinlichkeit von p = 0,1. Bei zehn unabhängigen Prüfungen soll die Wahrscheinlichkeit für genau zwei fehlerhafte Produkte berechnet werden. Hier passt die Binomialverteilung mit n = 10 und k = 2.
P(X = 2) = 45 · 0,12 · 0,98 ≈ 0,1937
Die Wahrscheinlichkeit beträgt also rund 19,4 %. Der Erwartungswert liegt bei μ = 10 · 0,1 = 1. Im Durchschnitt wäre bei zehn Produkten ein Fehler zu erwarten, genau zwei Fehler sind aber trotzdem keineswegs ungewöhnlich.
Für „mindestens ein fehlerhaftes Produkt“ rechne ich meist über das Gegenereignis:
P(X ≥ 1) = 1 - P(X = 0) = 1 - 0,910 ≈ 65,1 %
Das Gegenereignis spart hier mehrere Einzelrechnungen. Ein häufiger Denkfehler ist außerdem, den Erwartungswert als sichere Anzahl zu lesen. Ein Erwartungswert muss kein tatsächlich auftretender Wert sein, sondern beschreibt einen langfristigen Durchschnitt.
Warum bedingte Wahrscheinlichkeiten und Dateninterpretation anspruchsvoll sind
Eine bedingte Wahrscheinlichkeit berücksichtigt zusätzliche Informationen. Die Schreibweise P(A | B) bedeutet „Wahrscheinlichkeit von A unter der Bedingung B“. Das ist nicht automatisch dasselbe wie P(B | A), obwohl beide Ausdrücke sprachlich ähnlich klingen.
Ein Beispiel liefert ein medizinischer Test. Selbst wenn ein Test zuverlässig ist, hängt die Wahrscheinlichkeit für eine tatsächlich kranke Person nach einem positiven Ergebnis auch davon ab, wie häufig die Krankheit in der untersuchten Gruppe vorkommt. Diese Grundhäufigkeit wird als Basisrate bezeichnet und oft unterschätzt.
Für solche Aufgaben helfen Vierfeldertafeln oder ein Baumdiagramm. Ich empfehle, zunächst mit absoluten Zahlen zu arbeiten, etwa mit 10.000 getesteten Personen. Das macht bedingte Wahrscheinlichkeiten meist verständlicher als eine Folge abstrakter Formeln.
Lesen Sie auch: Lineare Unabhängigkeit - Definition, Prüfung & typische Fehler
Statistik braucht eine faire Datengrundlage
Bei statistischen Auswertungen zählt nicht nur die berechnete Zahl. Eine Stichprobe muss möglichst gut zur Grundgesamtheit passen, sonst entsteht ein Auswahlfehler. Werden nur Freiwillige befragt, können sich beispielsweise besonders interessierte oder besonders unzufriedene Personen überproportional beteiligen.
Auch ein Zusammenhang zwischen zwei Merkmalen beweist keine Ursache. Wenn in einer Stadt im Sommer mehr Eis verkauft und mehr Sonnenbrände beobachtet werden, verursacht das Eis nicht den Sonnenbrand. Beide Werte hängen wahrscheinlich mit einer dritten Größe zusammen, nämlich der höheren Sonneneinstrahlung.
Bei Diagrammen prüfe ich deshalb immer die Achsenskalierung, die Anzahl der Beobachtungen und die genaue Fragestellung. Ein auffälliger Prozentwert kann bei einer sehr kleinen Stichprobe zufällig entstanden sein. Gute Statistik zeigt nicht nur ein Ergebnis, sondern auch wie belastbar seine Grundlage ist.
So wird aus Rechnen echtes Verständnis
Wer sicher werden möchte, sollte nicht nur Formeln auswendig lernen. Sinnvoller ist eine Reihenfolge aus Situation, Modell, Rechnung und Interpretation. Zu jeder Lösung gehört mindestens ein Satz, der erklärt, was die Zahl im Beispiel bedeutet.
Beim Üben würde ich zuerst einfache Baumdiagramme und Gegenereignisse festigen, danach Zufallsvariablen und Binomialverteilungen einführen und erst dann bedingte Wahrscheinlichkeiten sowie statistische Schlussfolgerungen bearbeiten. Dieser Aufbau verhindert, dass man schwierige Verfahren benutzt, obwohl schon die Modellannahme nicht passt.
Der wichtigste Merksatz bleibt für mich schlicht: Zufall bedeutet nicht, dass alles beliebig ist. Mit passenden Daten, klaren Annahmen und sauberer Rechnung lassen sich unsichere Situationen erstaunlich präzise beschreiben, solange man die Grenzen des jeweiligen Modells ehrlich mitdenkt.